
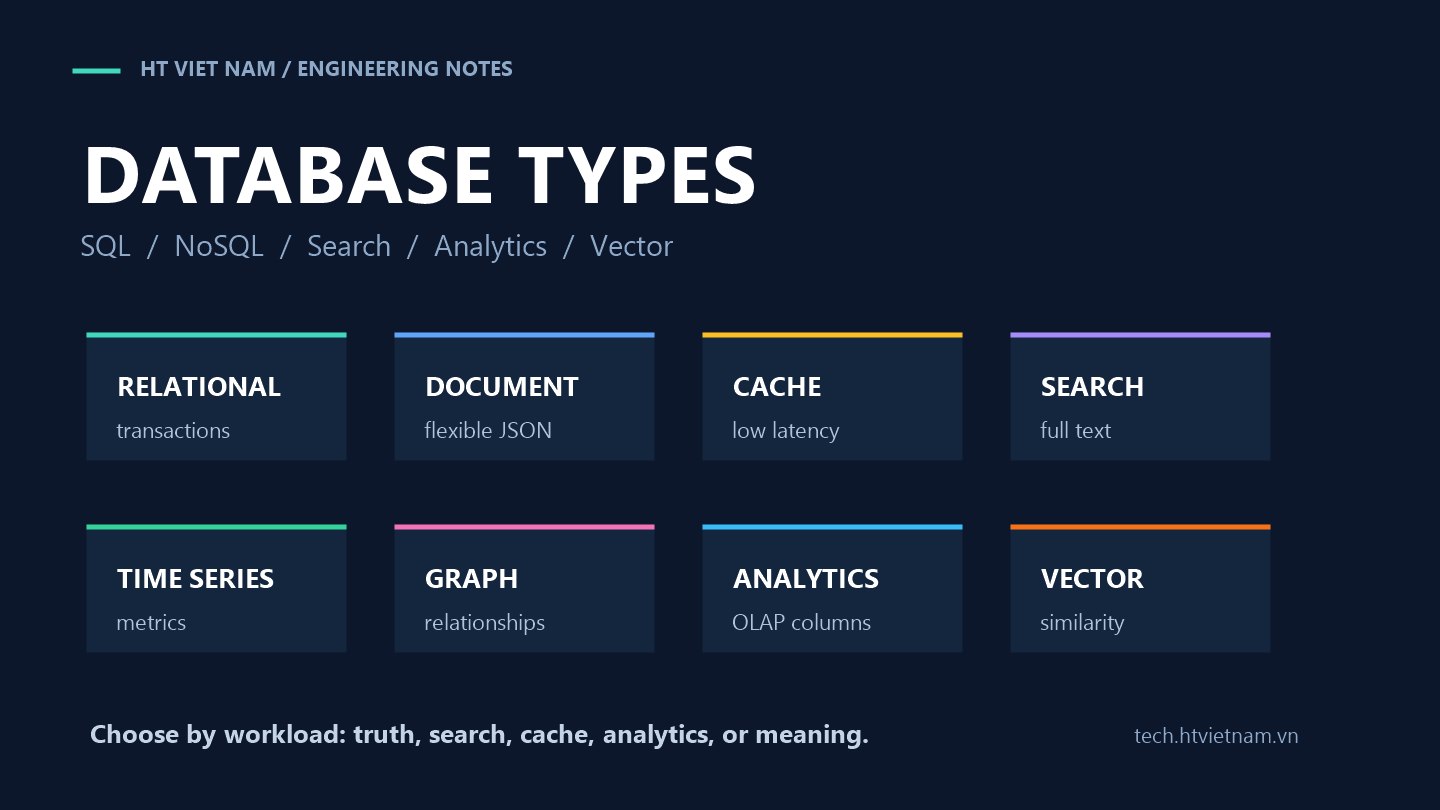
Không có database tốt nhất cho mọi hệ thống; chỉ có database phù hợp nhất với cách dữ liệu được ghi, đọc, tìm kiếm và phân tích. Một ứng dụng thương mại điện tử cần giao dịch chính xác, tìm kiếm sản phẩm, cache giỏ hàng, phân tích doanh thu và đôi khi còn cần gợi ý sản phẩm. Nếu cố nhét tất cả vào một loại database, hệ thống thường sẽ phức tạp theo cách khó sửa về sau.
1. Database quan hệ: PostgreSQL, MySQL, SQL Server, Oracle
Database quan hệ lưu dữ liệu theo bảng, hàng, cột và dùng SQL làm ngôn ngữ truy vấn chính. Điểm mạnh lớn nhất là tính nhất quán, transaction, ràng buộc dữ liệu, join và khả năng mô hình hóa nghiệp vụ có quan hệ rõ ràng. PostgreSQL, chẳng hạn, hỗ trợ SQL phong phú, transaction và nhiều kiểu dữ liệu mở rộng; tài liệu chính thức mô tả PostgreSQL là hệ quản trị cơ sở dữ liệu quan hệ đối tượng mã nguồn mở mạnh mẽ. Xem PostgreSQL About.
Loại này phù hợp với đơn hàng, thanh toán, kế toán, CRM, ERP, tài khoản người dùng, phân quyền và các nghiệp vụ cần câu trả lời đúng hơn câu trả lời nhanh bằng mọi giá. Khi cần thay đổi nhiều bảng cùng lúc và hoặc tất cả thành công hoặc tất cả rollback, database quan hệ vẫn là lựa chọn nền tảng.
Điểm yếu thường gặp là schema cần thiết kế cẩn thận, migration có thể nhạy cảm ở hệ thống lớn, scale write theo chiều ngang khó hơn một số mô hình NoSQL, và query join phức tạp có thể chậm nếu index hoặc mô hình dữ liệu sai. Tuy vậy, với phần lớn backend nghiệp vụ, relational database vẫn nên là mặc định đầu tiên trước khi chọn giải pháp chuyên biệt.
2. Document database: MongoDB, Couchbase
Document database lưu dữ liệu theo document, thường là JSON hoặc BSON. MongoDB mô tả document model là cách ánh xạ tự nhiên với object trong code và hỗ trợ dữ liệu linh hoạt, nested, thay đổi nhanh. Xem MongoDB Documents.
Document database phù hợp khi mỗi bản ghi là một aggregate tương đối độc lập: catalog sản phẩm có thuộc tính linh hoạt, hồ sơ người dùng có cấu trúc mở rộng, nội dung CMS, log nghiệp vụ, hoặc dữ liệu từ nhiều nguồn chưa ổn định schema. Thay vì normalize thành nhiều bảng và join liên tục, bạn có thể đọc một document lớn chứa phần lớn dữ liệu cần hiển thị.
Nhược điểm là dữ liệu dễ bị lặp, transaction đa document không nên bị lạm dụng, ràng buộc quan hệ không tự nhiên bằng SQL, và report phức tạp có thể khó hơn. Nếu nghiệp vụ có nhiều quan hệ chéo và cần toàn vẹn dữ liệu mạnh, document database nên được cân nhắc kỹ thay vì xem là thay thế trực tiếp cho relational database.
3. Key-value và cache: Redis, Memcached
Key-value database lưu dữ liệu theo cặp khóa và giá trị. Redis phổ biến vì chạy trong memory, hỗ trợ nhiều cấu trúc dữ liệu như string, list, set, sorted set, hash, stream và bitmap. Tài liệu Redis mô tả Redis là data structure server trong memory, có thể dùng cho cache, queue, stream processing và nhiều pattern realtime. Xem Redis data types.
Redis rất hợp cho cache session, rate limiting, distributed lock có kiểm soát, leaderboard, pub/sub, job queue nhẹ, token tạm thời và dữ liệu cần latency rất thấp. Khi đặt trước database chính, Redis có thể giảm tải đọc và hấp thụ spike traffic.
Nhưng Redis không nên trở thành nơi duy nhất lưu dữ liệu nghiệp vụ quan trọng nếu đội chưa thiết kế persistence, replication, backup và eviction policy. Memory đắt hơn disk, key không quản lý tốt dễ phình, và cache invalidation vẫn là bài toán khó. Hãy xem Redis là tầng tăng tốc hoặc xử lý realtime, không phải mặc định thay thế database chính.
4. Search engine: Elasticsearch, OpenSearch, Solr
Search engine được thiết kế để tìm kiếm văn bản, ranking, filtering và phân tích log ở tốc độ cao. Elasticsearch mô tả mình là search và analytics engine phân tán, dùng cho full-text search, observability và security analytics. Xem Elastic Stack overview.
Search database phù hợp khi người dùng cần tìm theo từ khóa, lỗi chính tả, relevance score, synonym, autocomplete, filter nhiều chiều hoặc phân tích log lớn. Ví dụ: tìm sản phẩm theo tên và mô tả, tìm bài viết, tra cứu log production, dashboard security event.
Điểm cần nhớ: search engine thường là bản sao phục vụ đọc, không phải source of truth. Dữ liệu nên được đồng bộ từ database chính qua pipeline rõ ràng. Nếu update đã thành công trong PostgreSQL nhưng index search chưa kịp cập nhật, ứng dụng phải chấp nhận độ trễ đồng bộ hoặc thiết kế luồng xử lý phù hợp.
5. Time-series database: InfluxDB, TimescaleDB, Prometheus
Time-series database tối ưu cho dữ liệu gắn timestamp: metric hạ tầng, sensor IoT, giá tài chính, event đo lường, latency và throughput. InfluxDB mô tả time series data là chuỗi điểm dữ liệu theo thời gian, thường ghi liên tục và truy vấn theo khoảng thời gian. Xem InfluxDB glossary: time series data.
Loại database này mạnh ở write throughput cao, retention policy, downsampling, aggregation theo cửa sổ thời gian và truy vấn như “CPU p95 theo mỗi 5 phút trong 7 ngày”. Prometheus lại rất phổ biến cho metrics vận hành và alerting trong Kubernetes.
Nhược điểm là không phù hợp làm database nghiệp vụ tổng quát. Nếu bạn cần transaction đơn hàng, join nhiều bảng hoặc truy vấn quan hệ phức tạp, time-series database không phải lựa chọn chính. Nó nên phục vụ metrics và đo lường, bên cạnh database nghiệp vụ.
6. Graph database: Neo4j, Amazon Neptune
Graph database biểu diễn dữ liệu bằng node, relationship và property. Neo4j giải thích graph database phù hợp khi quan hệ giữa dữ liệu quan trọng ngang hoặc quan trọng hơn bản thân bản ghi. Xem Neo4j graph database concepts.
Graph database rất hợp cho mạng xã hội, recommendation, fraud detection, knowledge graph, quản lý quyền truy cập nhiều tầng, đường đi ngắn nhất, dependency graph và câu hỏi như “người dùng A liên quan thế nào đến tổ chức B qua tối đa 3 bước?”.
Nhược điểm là đội cần học mô hình graph và ngôn ngữ truy vấn riêng như Cypher hoặc Gremlin. Nếu dữ liệu chủ yếu là bảng nghiệp vụ bình thường và quan hệ đơn giản, relational database với index tốt có thể đủ. Graph database tỏa sáng khi truy vấn theo mối quan hệ sâu là phần cốt lõi của sản phẩm.
7. Analytical columnar database: ClickHouse, BigQuery, Snowflake, Redshift
Analytical database dạng columnar tối ưu cho đọc nhiều dòng nhưng chỉ vài cột, aggregation lớn và dashboard BI. ClickHouse mô tả mình là hệ quản trị cơ sở dữ liệu column-oriented cho online analytical processing, tức OLAP. Xem ClickHouse Introduction.
Loại này phù hợp với event analytics, báo cáo doanh thu lớn, phân tích hành vi người dùng, log analytics, cohort, funnel và truy vấn scan hàng tỷ dòng. Vì lưu theo cột, nó đọc ít dữ liệu hơn khi query chỉ cần vài field và nén dữ liệu tốt hơn trong nhiều workload.
Nhược điểm là không nên dùng thay transactional database. Update từng dòng nhỏ, transaction nghiệp vụ và ràng buộc quan hệ không phải thế mạnh chính. Kiến trúc phổ biến là PostgreSQL/MySQL làm source of truth, sau đó stream hoặc batch dữ liệu sang ClickHouse/warehouse để phân tích.
8. Vector database: Milvus, Pinecone, Weaviate, pgvector
Vector database lưu embedding và tìm kiếm theo độ tương đồng. Milvus mô tả vector database là hệ thống chuyên lưu, index và tìm kiếm vector embedding sinh từ mô hình machine learning. Xem Milvus overview.
Loại này trở nên phổ biến nhờ semantic search, RAG, tìm sản phẩm tương tự, recommendation, nhận diện hình ảnh, deduplicate nội dung và tìm kiếm theo ý nghĩa thay vì chỉ theo keyword. Nếu người dùng tìm “laptop nhẹ cho sinh viên” nhưng sản phẩm không chứa đúng cụm từ đó, embedding search có thể tìm kết quả gần nghĩa.
Nhược điểm là kết quả thường mang tính xấp xỉ và phụ thuộc mạnh vào model embedding, chunking, metadata filter và cách đánh giá chất lượng. Vector database cũng không thay thế database chính; nó thường đi cùng relational/document database để lưu metadata, phân quyền, trạng thái và dữ liệu nguồn.
9. Bảng so sánh nhanh
| Loại database | Mạnh nhất ở | Không nên dùng làm gì | Ví dụ |
|---|---|---|---|
| Relational | Transaction, dữ liệu nghiệp vụ, join, toàn vẹn | Search text phức tạp hoặc analytics cực lớn nếu đứng một mình | PostgreSQL, MySQL |
| Document | Dữ liệu linh hoạt, aggregate đọc một lần | Quan hệ chéo dày đặc, ràng buộc mạnh nhiều bảng | MongoDB, Couchbase |
| Key-value/cache | Latency thấp, cache, counter, queue nhẹ | Source of truth chưa có persistence/backup rõ | Redis, Memcached |
| Search | Full-text search, ranking, log search | Transaction nghiệp vụ chính | Elasticsearch, OpenSearch |
| Time-series | Metric theo thời gian, retention, downsampling | Dữ liệu nghiệp vụ quan hệ phức tạp | InfluxDB, Prometheus |
| Graph | Quan hệ sâu, path, recommendation, fraud | CRUD bảng đơn giản không cần traversal | Neo4j, Neptune |
| Columnar analytics | OLAP, dashboard, aggregation lớn | Transaction OLTP từng request | ClickHouse, BigQuery |
| Vector | Semantic search, RAG, similarity | Lưu nghiệp vụ chính hoặc bảo đảm đúng tuyệt đối | Milvus, Pinecone, pgvector |
10. Cách chọn trong dự án thật
- Chọn source of truth trước: phần lớn hệ thống nghiệp vụ nên bắt đầu bằng relational database nếu chưa có lý do mạnh để khác đi.
- Tách workload đọc đặc biệt: search, analytics, cache, vector search và metrics thường là projection hoặc bản sao từ dữ liệu chính.
- Đừng tối ưu trước khi có traffic: thêm database mới đồng nghĩa thêm backup, monitoring, phân quyền, migration và đồng bộ dữ liệu.
- Thiết kế độ trễ đồng bộ: nếu search index chậm vài giây, UI và nghiệp vụ phải chấp nhận được.
- Đánh giá theo câu hỏi truy vấn: hệ thống cần transaction, full-text, aggregation, time window, graph traversal hay similarity search?
- Ưu tiên năng lực đội: database tốt nhưng đội không vận hành được sẽ trở thành rủi ro production.
11. Một kiến trúc phổ biến
Một hệ thống SaaS có thể dùng PostgreSQL làm source of truth cho user, subscription và invoice; Redis cho session và rate limit; Elasticsearch/OpenSearch cho tìm kiếm; ClickHouse cho analytics; Prometheus cho metrics; và vector database cho semantic search trong tài liệu. Mỗi loại xử lý một workload rõ ràng, thay vì một database phải gánh mọi nhiệm vụ.
Điểm mấu chốt là ranh giới trách nhiệm. Database chính trả lời “dữ liệu đúng là gì?”. Search engine trả lời “người dùng tìm thấy gì?”. Analytics database trả lời “điều gì đang xảy ra ở quy mô lớn?”. Cache trả lời “làm sao đọc nhanh hơn?”. Vector database trả lời “cái gì gần nghĩa nhất?”. Khi trả lời được những câu này, lựa chọn database sẽ bớt chạy theo xu hướng và gần hơn với nhu cầu thật của sản phẩm.




Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.