
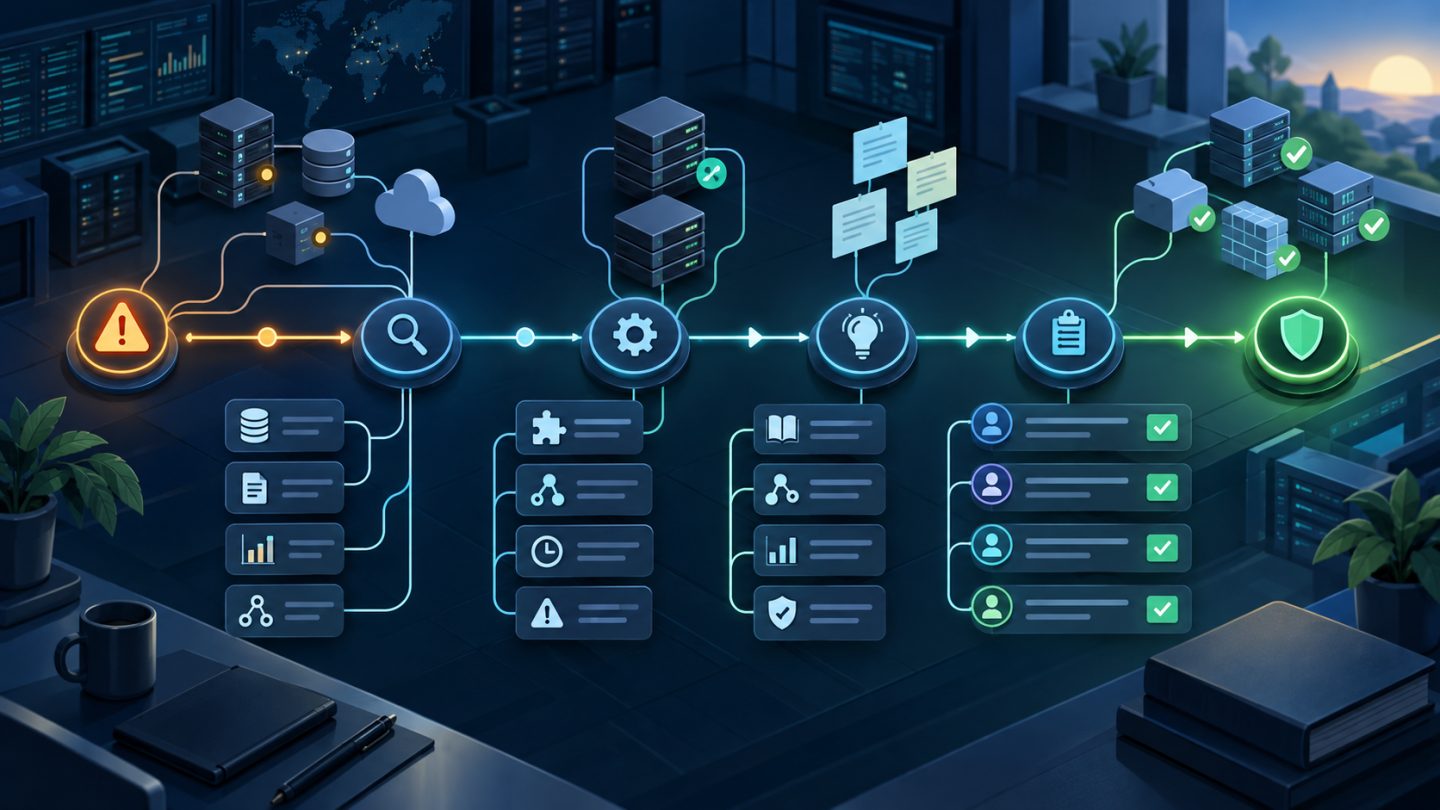
Một sự cố chỉ thật sự kết thúc khi tổ chức hiểu điều gì đã xảy ra, giảm khả năng tái diễn và theo dõi các cải tiến đến trạng thái có thể xác minh. Khôi phục dịch vụ mới xử lý phần tác động tức thời. Nếu timeline, tín hiệu bị bỏ lỡ, quyết định khi ứng cứu và điểm yếu hệ thống không được ghi lại, nhóm sau sẽ phải học lại cùng bài học trong một ca trực khác.
Postmortem là hồ sơ bằng văn bản về impact, diễn biến, biện pháp giảm thiểu, các yếu tố góp phần và hành động theo sau. “Blameless” không có nghĩa không ai chịu trách nhiệm. Nó loại bỏ phán xét cá nhân khỏi phân tích để dữ kiện được nói ra, đồng thời đặt owner và deadline rõ cho công việc cải thiện hệ thống.
1. Định nghĩa trước sự cố nào cần postmortem
Nếu tiêu chí chỉ được quyết định sau sự cố, nhóm dễ bỏ qua incident gây khó chịu hoặc dùng postmortem như hình phạt cho người trực. Hãy định nghĩa trigger trước và áp dụng nhất quán. Google SRE gợi ý các trường hợp như downtime/degradation vượt ngưỡng, mất dữ liệu, on-call phải rollback/reroute, thời gian khôi phục vượt ngưỡng hoặc monitoring không phát hiện sự cố.
- SLO hoặc error budget bị ảnh hưởng đáng kể.
- Có rủi ro bảo mật, dữ liệu hoặc tuân thủ.
- Cần thao tác khẩn cấp ngoài runbook.
- Near miss cho thấy safeguard đã suýt thất bại.
- Sự cố lặp lại dù impact từng lần nhỏ.
- Bất kỳ stakeholder nào có lý do học tập hợp lệ yêu cầu review.
Không phải mọi cảnh báo đều cần tài liệu dài. Có thể dùng review nhẹ cho incident nhỏ và postmortem đầy đủ cho sự kiện lớn. Quan trọng là severity, trigger và thời hạn hoàn thành được biết trước.
2. Tách ứng cứu khỏi phân tích sâu
Trong incident, ưu tiên là bảo vệ người dùng, giới hạn blast radius, khôi phục dịch vụ và giao tiếp. Incident commander không nên trì hoãn mitigation để tranh luận root cause. Tuy nhiên, responder cần giữ bằng chứng: timestamp UTC, alert, dashboard, command, thay đổi cấu hình, quyết định và kết quả. Một scribe riêng giúp timeline không phụ thuộc trí nhớ sau ca trực.
Sau khi hệ thống ổn định, freeze hoặc bảo toàn dữ liệu điều tra cần thiết theo policy. Không sao chép token, thông tin khách hàng hay payload nhạy cảm vào tài liệu chung. Liên kết tới hệ thống kiểm soát quyền thay vì dán secret vào postmortem.
Timeline tốt ghi điều nhóm biết tại từng thời điểm, không dùng kiến thức có sau sự cố để phán xét quyết định trước đó.
3. Mở đầu bằng impact đo được
Người đọc cần hiểu ai bị ảnh hưởng, trong bao lâu và mức độ nào trước khi xem chi tiết kỹ thuật. Ghi thời gian bắt đầu/kết thúc theo UTC, khu vực, sản phẩm, tỷ lệ request lỗi, latency, số tenant/user ước tính và tác động dữ liệu/doanh thu nếu đã được xác minh.
| Nên viết | Tránh viết |
|---|---|
| “Từ 09:12–09:47 UTC, 18% request checkout ở vùng A trả 503.” | “Checkout hơi chậm trong một lúc.” |
| “Không có bằng chứng mất dữ liệu; 312 order bị giữ pending và đã reconcile.” | “Có vẻ dữ liệu ổn.” |
| “Alert đầu tiên sau impact 11 phút; support báo trước monitoring 4 phút.” | “Monitoring không tốt.” |
Phân biệt fact, estimate và unknown. Nếu số liệu chưa chắc, ghi phương pháp ước tính và cập nhật sau. Không thổi phồng độ chính xác để báo cáo đẹp.
4. Dựng timeline từ nhiều nguồn
Ghép deployment log, alert, chat incident, audit trail, metric, trace và ticket. Dùng một timezone, tốt nhất UTC, và timestamp đủ chính xác. Mỗi dòng nên có event, actor theo vai trò nếu cần, evidence link và ảnh hưởng lên trạng thái incident.
09:12 UTC  Error rate vượt 5%; alert chưa firing do cửa sổ 15 phút.
09:19 UTC  Support mở ticket từ phản hồi khách hàng.
09:23 UTC  On-call xác nhận checkout 503, khai báo SEV-1.
09:27 UTC  Correlation cho thấy pool kết nối database cạn.
09:32 UTC  Giảm concurrency worker; error rate bắt đầu giảm.
09:47 UTC  Service phục hồi; tiếp tục giám sát và reconcile.
Timeline không chỉ liệt kê command. Nó cần cho thấy detect, acknowledge, diagnose, mitigate, recover và validate. Khoảng trống dài là tín hiệu cần điều tra: thiếu telemetry, ownership mơ hồ hay công cụ truy cập chậm.
5. Phân tích trigger, yếu tố góp phần và safeguard thất bại
Một “root cause” duy nhất thường quá đơn giản cho hệ thống phức tạp. Hãy phân biệt trigger gần nhất với điều kiện cho phép incident lan rộng. Ví dụ, deployment tăng concurrency là trigger; connection pool không có headroom, load test thiếu kịch bản, alert chậm và rollback phụ thuộc quyền thủ công là các yếu tố góp phần.
Hỏi nhiều lớp:
- Điều gì thay đổi ngay trước impact?
- Vì sao thay đổi hợp lệ qua review/test?
- Safeguard nào đáng lẽ giới hạn blast radius?
- Tín hiệu nào tồn tại nhưng không được nhìn thấy hoặc bị hiểu sai?
- Điều gì làm detection, diagnosis hay mitigation lâu hơn?
- Điều gì đã hoạt động tốt và nên được giữ?
“Human error” không phải điểm dừng. Nếu một command hợp lệ có thể xóa cả cluster, hãy hỏi vì sao quyền, dry-run, confirmation, scope limit và recovery không ngăn hoặc giảm tác động.
6. Blameless không xóa accountability
Ngôn ngữ blameless mô tả hành động và context: “Runbook hướng dẫn restart cả pool; responder dùng thông tin sẵn có và restart làm tăng tải.” Ngôn ngữ đổ lỗi nói: “Kỹ sư đã restart sai.” Câu đầu cho phép sửa runbook, thêm guard và cải thiện đào tạo; câu sau khiến người khác che giấu near miss.
Tuy vậy, tổ chức vẫn cần accountability:
- Service có owner chịu trách nhiệm độ tin cậy.
- Action item có một owner, deadline và tiêu chí hoàn tất.
- Quyết định rủi ro có người phê duyệt và audit trail.
- Vi phạm cố ý hoặc hành vi ngoài policy được xử lý bằng quy trình nhân sự riêng, không trộn vào phân tích kỹ thuật.
Giả định thiện chí không có nghĩa mọi quyết định đều tốt; nó tạo điều kiện xem xét vì sao quyết định đó có vẻ hợp lý lúc ấy.
7. Action item phải thay đổi hệ thống và đo được
“Cẩn thận hơn”, “đào tạo lại” hoặc “theo dõi” không có trạng thái hoàn tất rõ. Một action tốt mô tả thay đổi, owner, priority, deadline, evidence và rủi ro được giảm. Cân bằng ba nhóm:
- Prevent: loại bỏ hoặc chặn failure mode, như giới hạn concurrency tự động.
- Detect: phát hiện nhanh hơn, như alert theo saturation trước lỗi 503.
- Mitigate: giảm impact/MTTR, như kill switch, fallback hoặc rollback một bước.
| Action mơ hồ | Action có thể xác minh |
|---|---|
| Thêm monitoring tốt hơn | Tạo alert khi pool utilization > 80% trong 5 phút; diễn tập alert ở staging; owner Platform; hạn 15/10. |
| Cập nhật runbook | Thêm bước kiểm tra headroom và rollback; một on-call khác chạy game day thành công. |
| Tránh deploy lỗi | Canary 5% trong 15 phút, tự dừng khi error budget burn vượt ngưỡng. |
Không tạo danh sách hàng chục việc ưu tiên ngang nhau. Chọn hành động có leverage cao và theo dõi đến khi đóng. Nếu item bị hủy, ghi lý do và rủi ro được chấp nhận bởi ai.
8. Review meeting để kiểm chứng, không xét xử
Gửi draft trước. Facilitator nhắc mục tiêu học tập, giữ thảo luận trên fact và system, đồng thời mời các nhóm bị ảnh hưởng. Responder không nên phải tự bảo vệ danh dự. Reviewer kiểm tra impact, độ sâu phân tích, tính hợp lý của action và câu hỏi còn mở.
- Xác nhận impact và timeline.
- Làm rõ điểm chưa biết, không lấp bằng suy đoán.
- Kiểm tra trigger và contributing factors qua evidence.
- Đánh giá action theo prevent/detect/mitigate.
- Chốt owner, deadline, reviewer và cách verify.
- Xác định phạm vi chia sẻ và nội dung cần redact.
Cuộc họp không nên trì hoãn việc sửa lỗi rõ ràng. Action khẩn cấp có thể bắt đầu trước khi tài liệu hoàn tất nhưng phải được liên kết và hậu kiểm.
9. Chia sẻ kiến thức mà không làm lộ dữ liệu
Postmortem có giá trị khi đội khác tìm được bài học. Lưu trong repository có search, metadata thống nhất và access control. Chia sẻ rộng nhất có thể nhưng loại thông tin nhận diện khách hàng, secret, exploit chưa vá, chi tiết pháp lý hoặc dữ liệu thuộc phạm vi điều tra.
Metadata hữu ích gồm service, severity, failure domain, detection source, contributing-factor tags và action status. Tổng hợp theo quý có thể phát hiện theme: alert chậm, quyền khẩn cấp, capacity, dependency, schema migration hoặc runbook thiếu. Không dùng số lượng postmortem để xếp hạng đội “kém”; đội báo cáo trung thực có thể trông nhiều incident hơn đội che giấu.
10. Theo dõi sau khi tài liệu được publish
Một postmortem hay nhưng action không đóng chỉ là văn bản. Đưa item vào backlog chính, gắn priority theo rủi ro và review định kỳ với leadership. SLO cho việc hoàn thành item phải thực tế nhưng không để feature work lấn vô hạn. Khi incident tương tự tái diễn, liên kết các postmortem và hỏi action cũ thiếu, chậm hay sai hướng.
Verify bằng bằng chứng: test mới, dashboard, game day, config policy hoặc thời gian phục hồi đo được. “Merged” không đồng nghĩa “effective”. Một alert chỉ hoàn thành khi firing đúng và người trực biết phản ứng.
Template gợi ý
# Incident title
Status / Severity / Owners / Review date

## Executive summary
## Customer and business impact
## Detection
## Timeline (UTC)
## Trigger and contributing factors
## What went well
## What went poorly
## Where we got lucky
## Corrective actions
| Action | Type | Owner | Due | Verification |
## Open questions
## References and evidence
Checklist chất lượng
- Impact có số liệu, thời gian và mức độ chắc chắn.
- Timeline dùng UTC, evidence và trạng thái incident.
- Phân tích system/context thay vì gắn nhãn cá nhân.
- Trigger không bị nhầm với toàn bộ nguyên nhân.
- Có điều đã hoạt động tốt và yếu tố may mắn.
- Action có owner, deadline, priority và verification.
- Secret và dữ liệu khách hàng đã được loại/redact.
- Tài liệu được review, publish và action được theo dõi.
Tài liệu tham khảo
- Google SRE Workbook: Postmortem Culture
- Google SRE Book: Postmortem Culture
- Google Cloud Architecture Framework: Conduct thorough postmortems
- Microsoft Azure Well-Architected: Incident management
Kết luận
Postmortem tốt biến một sự cố thành thay đổi có thể kiểm chứng. Nó trung thực về impact, tái dựng timeline theo dữ kiện, xem con người trong context của hệ thống và tạo action có owner. Blamelessness giúp thông tin được nói ra; accountability đảm bảo bài học trở thành công việc. Khi tổ chức review, chia sẻ và đóng action một cách đều đặn, postmortem không còn là nghi thức sau outage mà trở thành cơ chế cải thiện độ tin cậy.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.