
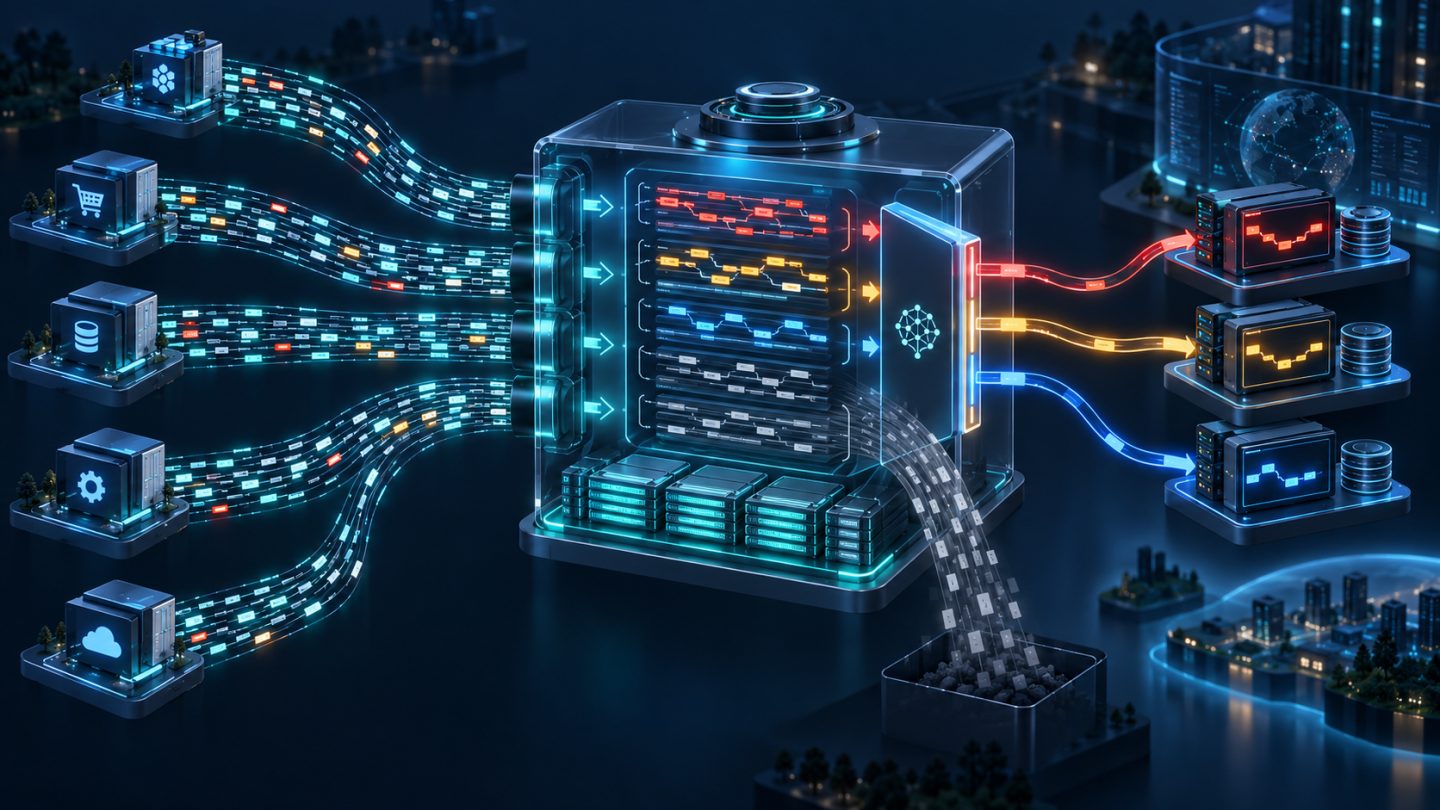
Tail sampling cho phép đợi đến khi trace gần hoàn chỉnh rồi mới quyết định giữ hay bỏ. Nhờ vậy, đội vận hành có thể giữ gần như toàn bộ trace lỗi và trace chậm, đồng thời chỉ lấy một phần nhỏ traffic bình thường. Đổi lại, OpenTelemetry Collector phải giữ trạng thái trong bộ nhớ, mọi span cùng một trace phải đến đúng một sampler, và hệ thống cần được thiết kế cho late span, burst traffic lẫn sự cố Collector.
Bài viết dựa trên tài liệu chính thức của OpenTelemetry Tail Sampling Processor và Collector configuration. Processor này thuộc các distribution contrib/Kubernetes và đang ở mức beta cho traces tại thời điểm viết; hãy pin phiên bản Collector và kiểm tra tài liệu đúng phiên bản trước khi triển khai.
1. Head sampling và tail sampling khác nhau ở đâu?
| Tiêu chí | Head sampling | Tail sampling |
|---|---|---|
| Thời điểm quyết định | Khi trace vừa bắt đầu | Sau khi đã thấy nhiều hoặc gần đủ span |
| Thông tin dùng để chọn | Trace ID, xác suất, thuộc tính ban đầu | Status, latency và thuộc tính của toàn trace |
| Chi phí trước quyết định | Thấp; span bị bỏ có thể không rời ứng dụng | Cao hơn; Collector phải nhận và giữ span |
| Khả năng giữ lỗi hiếm | Có thể bỏ lỡ nếu quyết định quá sớm | Tốt hơn khi lỗi chỉ xuất hiện ở span cuối |
Tail sampling giảm lượng dữ liệu xuất sang backend, nhưng không miễn phí ở đoạn từ ứng dụng đến sampler. Network, CPU và memory của Collector vẫn phải xử lý telemetry trước khi quyết định. Nếu chỉ cần giữ ngẫu nhiên 5% trace và không dùng thông tin cuối trace, probabilistic head sampling thường đơn giản và hiệu quả hơn.
2. Điều kiện bất biến: cùng trace phải về cùng sampler
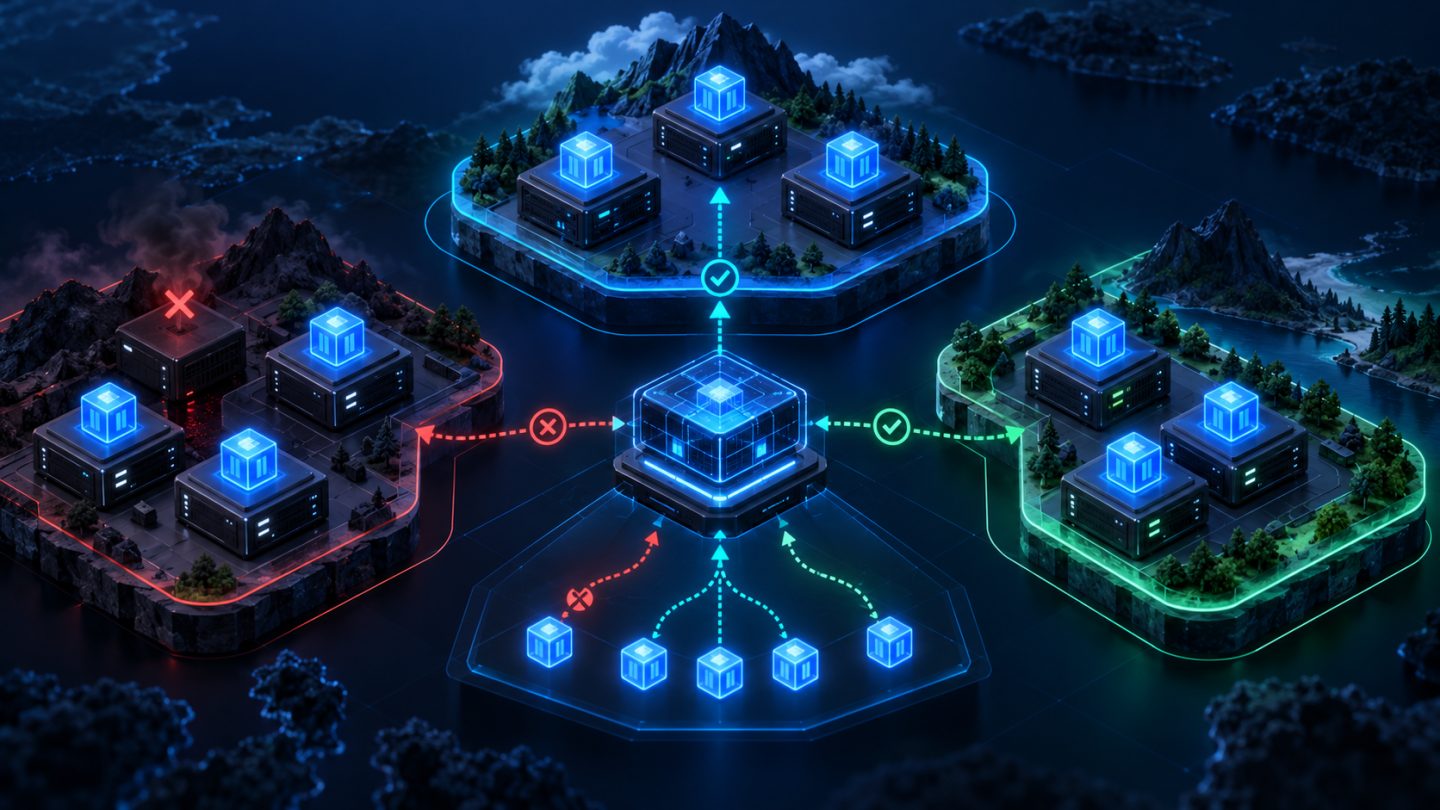
Tail sampler nhóm span theo trace_id. Nếu các span của một trace bị chia cho ba Collector, mỗi instance chỉ thấy một mảnh và có thể ra quyết định sai hoặc xuất trace thiếu. Round-robin load balancing thông thường không đáp ứng điều kiện này.
Mô hình production phổ biến gồm hai tầng:
- Agent hoặc gateway nhận OTLP, làm enrichment/redaction cần thiết.
- Load-balancing exporter định tuyến nhất quán theo trace ID.
- Một pool Collector riêng chạy tail sampling và export sang backend.
Tách hai tầng giúp scale phần nhận dữ liệu độc lập với phần giữ trạng thái, đồng thời giảm blast radius. Sau khi thay số replica sampler, phải kiểm tra tác động của việc đổi vòng hash lên các trace đang chờ quyết định.
3. Pipeline tối thiểu có kiểm soát
processors:
  memory_limiter:
    check_interval: 1s
    limit_mib: 4096
    spike_limit_mib: 1024

  k8sattributes: {}

  tail_sampling:
    decision_wait: 15s
    num_traces: 50000
    expected_new_traces_per_sec: 2000
    decision_cache:
      sampled_cache_size: 500000
      non_sampled_cache_size: 1000000
    policies:
      - name: keep-errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: keep-slow
        type: latency
        latency:
          threshold_ms: 1500
      - name: normal-baseline
        type: probabilistic
        probabilistic:
          sampling_percentage: 5

  batch: {}

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors:
        - memory_limiter
        - k8sattributes
        - tail_sampling
        - batch
      exporters: [otlp]
Các con số trên chỉ là ví dụ, không phải default production. Tail sampling phải đứng sau processor cần context gốc như k8sattributes, vì nó gom lại span thành batch mới. Batch processor thường đặt sau tail sampler. Nếu cần loại secret, hãy redaction trước khi span đi vào bộ đệm và kiểm thử rằng policy vẫn còn đủ thuộc tính để quyết định.
4. Policy là contract kinh doanh, không phải tập rule ngẫu hứng
Một bộ policy khởi đầu thường giữ:
- trace có span status
ERROR; - trace vượt SLO latency, ví dụ 1.500 ms;
- trace của tenant hoặc endpoint quan trọng;
- một baseline xác suất nhỏ để quan sát đường đi bình thường.
Nhiều policy có semantics kết hợp riêng; một policy khớp không nhất thiết làm các policy sau ngừng đánh giá, còn drop policy có thể ảnh hưởng kết quả chung. Đọc decision flow đúng phiên bản thay vì suy luận rằng danh sách luôn chạy như chuỗi if/else. Với rule phức tạp, tạo test fixtures gồm trace phải giữ, phải bỏ và trace có dữ liệu thiếu.
Không dùng thuộc tính cardinality cao không kiểm soát như user ID cho hàng nghìn rule riêng. Chuẩn hóa các thuộc tính bền vững như service.name, route template, deployment environment và error class.
5. Sizing bộ nhớ từ lưu lượng thật
Bộ nhớ cần thiết phụ thuộc vào số trace mới mỗi giây, thời gian chờ, số span mỗi trace, kích thước span và overhead của Collector. Ước lượng ban đầu:
pending_traces ≈ new_traces_per_second × decision_wait_seconds
buffer_bytes ≈ pending_traces × average_spans_per_trace
               × average_span_bytes × safety_factor
Ví dụ 2.000 trace/giây và chờ 15 giây đã tạo khoảng 30.000 trace đang chờ trước khi tính burst và late span. Đo kích thước thực tế bằng load test; không coi phép nhân này là cam kết dung lượng. num_traces phải đủ headroom nhưng không được biến thành lời hứa vượt giới hạn pod.
memory_limiter là hàng rào cuối, không thay cho sizing. Khi Collector chạm giới hạn, retry từ upstream có thể làm áp lực tăng thêm. Đặt request/limit, queue và retry budget thành một thiết kế thống nhất.
6. Chọn decision_wait bằng dữ liệu late span
Chờ quá ngắn làm trace bị quyết định trước khi span chậm tới; chờ quá dài tăng memory và độ trễ quan sát. Bắt đầu từ phân phối end-to-end latency và thời gian span đến Collector, sau đó xem metric về tuổi late span.
- Đo p95/p99 thời gian từ span đầu đến span cuối tới sampler.
- Tách latency ứng dụng khỏi delay do queue, retry hoặc network.
- Quan sát tỷ lệ late span sau quyết định.
- Thay đổi
decision_waittừng bước và đo memory/coverage.
Decision cache giúp các span tới muộn dùng lại quyết định trước đó, nhưng cache quá nhỏ có thể quên trace sớm. Cache lớn lại tiêu thụ memory. Cần theo dõi cả sampled và non-sampled cache theo traffic thật.
7. Sampling không sửa được instrumentation sai
Nếu service không propagate trace context, một request sẽ vỡ thành nhiều trace. Tail sampler không thể tự ghép chúng. Nếu SDK không ghi status lỗi hoặc route attribute không nhất quán, policy sẽ bỏ mất sự kiện cần giữ.
Trước rollout, kiểm tra:
- W3C Trace Context được propagate qua HTTP, message broker và background job;
- server/client spans có parent đúng;
service.name, environment và route template ổn định;- exception được record nhưng không đưa secret vào attributes;
- clock skew và batch delay nằm trong giới hạn đã đo.
8. Quyền riêng tư: span bị bỏ vẫn từng nằm trong Collector
Tail sampling không phải data-loss-prevention. Collector nhận dữ liệu trước rồi mới bỏ, nên password, token, nội dung request nhạy cảm vẫn đã đi qua network và memory. Ưu tiên không thu thập từ SDK; bổ sung allowlist/redaction sớm trong pipeline và mã hóa OTLP khi truyền.
Giới hạn quyền truy cập config, debug endpoint và log Collector. Không bật payload logging trên production để “xem thử trace”. Chính sách retention ở backend chỉ áp dụng cho trace được export, không thay kiểm soát dữ liệu tại nguồn.
9. High availability và failure mode
Tail sampler là stateful nhưng thường không có replication đồng bộ cho buffer trong memory. Khi pod restart, các trace đang chờ có thể bị thiếu hoặc mất; rolling deployment cũng có thể làm lệch routing tạm thời. Thiết kế cần chấp nhận và đo được khoảng mất này.
- Dùng PodDisruptionBudget và graceful termination phù hợp.
- Không rollout toàn bộ sampler cùng lúc.
- Đặt readiness để instance chỉ nhận traffic khi pipeline sẵn sàng.
- Load test khi scale out/in, restart và backend chậm.
- Quyết định rõ fail-open hay backpressure khi exporter không dùng được.
Persistent tail storage đang là khả năng thử nghiệm ở các phiên bản hiện đại, không nên mặc định coi nó là lớp HA hoàn chỉnh. Nếu sử dụng feature gate, phải đánh giá stability và quy trình upgrade riêng.
10. Metric bắt buộc phải theo dõi
| Nhóm | Tín hiệu cần xem |
|---|---|
| Ingest | Accepted/refused spans, trace mới mỗi giây |
| Buffer | Trace đang nằm trong memory, memory/RSS, GC |
| Decision | Trace sampled/not sampled/dropped theo policy |
| Quality | Late span age, trace bị loại quá sớm hoặc quá lớn |
| Policy | Evaluation errors và execution time |
| Export | Queue size, send failures, retry và dropped spans |
Tên metric cụ thể có thể đổi theo phiên bản và feature gate. Pin dashboard cùng Collector release, kiểm tra endpoint internal telemetry sau mỗi lần nâng cấp. Alert không chỉ dựa vào CPU: một sampler CPU thấp nhưng drop trace vì đầy buffer vẫn đang hỏng.
11. Đo chi phí đúng cách
Tỷ lệ trace giữ lại không bằng tỷ lệ byte giữ lại: một trace lỗi có thể nhiều span hơn trace bình thường. Theo dõi bytes/spans exported và hóa đơn backend, không chỉ đếm trace. Tail sampling cũng làm dữ liệu không còn là mẫu ngẫu nhiên thuần túy; dashboard tính tỷ lệ lỗi trực tiếp từ trace đã chọn sẽ bị bias.
Dùng metrics chuẩn cho SLI/SLO và volume tổng. Trace phục vụ điều tra đường đi, không nên bị biến thành nguồn duy nhất để ước lượng error rate nếu sampling policy ưu tiên lỗi.
12. Lộ trình rollout an toàn
- Chuẩn hóa instrumentation và đo lưu lượng span/trace hiện tại.
- Chạy một pipeline shadow, chưa cắt dữ liệu backend hiện hữu.
- Replay/load test với error, latency, giant trace và late span.
- So sánh trace coverage, bytes export, memory và decision latency.
- Canary một nhóm service; giữ đường rollback cấu hình nhanh.
- Mở rộng dần, theo dõi restart/scale event và chi phí thực.
- Review policy định kỳ khi SLO, route hoặc kiến trúc thay đổi.
Checklist production
- Collector distribution và version được pin.
- Mọi span cùng trace được route về cùng sampler theo trace ID.
- Processor cần context và redaction đứng trước tail sampling; batch đứng sau.
decision_wait,num_tracesvà cache dựa trên load test.- Có baseline probabilistic bên cạnh error/latency policies.
- Memory limiter, resource limit, queue và retry budget nhất quán.
- Dashboard theo dõi late span, buffer, decision, policy error và export failure.
- Đã thử restart, rolling update, scale và backend outage.
- Không dùng sampled traces để tính trực tiếp tỷ lệ lỗi toàn hệ thống.
- Policy/config có version, review, canary và rollback.
Kết luận
Tail sampling đáng dùng khi giá trị của trace chỉ lộ ra sau khi request hoàn tất: lỗi hiếm, latency cao hoặc hành trình qua nhiều service. Giá trị đó đi cùng chi phí trạng thái và yêu cầu định tuyến nghiêm ngặt. Một triển khai tốt bắt đầu bằng trace context đúng, gom cùng trace về cùng Collector, sizing bằng số liệu thật, giữ baseline không thiên lệch và quan sát chính sampler như một dịch vụ production.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.