
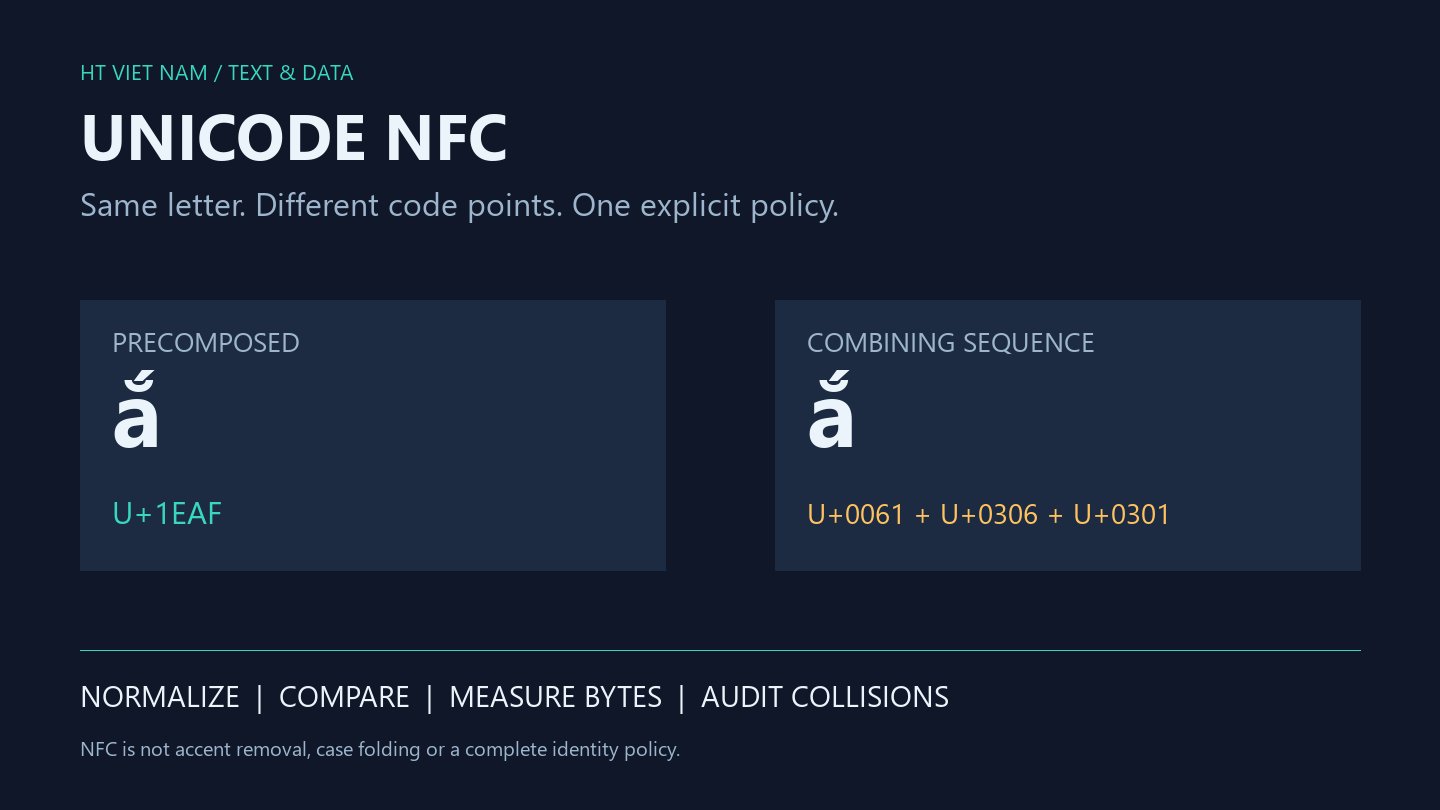
Hai tên được hiển thị giống nhau, nhưng tìm kiếm chính xác không thấy hoặc hệ thống cho tạo bản ghi trùng. Một nguyên nhân là cùng chữ tiếng Việt có thể được biểu diễn bằng các chuỗi mã Unicode khác nhau. Nhìn bằng mắt chưa đủ kết luận hai chuỗi có cùng dữ liệu.
Bài viết dùng chữ “ắ” và JavaScript để minh họa dạng dựng sẵn, dạng tổ hợp và chuẩn hóa NFC. Đây là bài về biểu diễn văn bản; chính sách định danh, tìm kiếm và dữ liệu nghiệp vụ vẫn cần được thiết kế riêng.
1. Một chữ có thể có nhiều cách biểu diễn
const composed = '\u1EAF';
const decomposed = 'a\u0306\u0301';

console.log(composed);               // ắ
console.log(decomposed);             // ắ
console.log(composed === decomposed); // false
console.log(composed.length);        // 1
console.log(decomposed.length);      // 3
Chuỗi thứ nhất dùng một code point U+1EAF; chuỗi thứ hai dùng a, dấu breve và dấu sắc kết hợp. Hai cách này có quan hệ tương đương chuẩn tắc. Unicode Standard Annex #15 định nghĩa các dạng chuẩn hóa phục vụ việc xử lý những biểu diễn như vậy.
Ví dụ dùng escape để code giữ rõ ý nghĩa khi được copy qua editor, JSON hay tài liệu. Trong điều tra lỗi thực tế, lưu code point của một mẫu nhỏ sẽ hữu ích hơn chụp màn hình hai chữ giống nhau.
2. Đưa cả hai phía về NFC trước khi so sánh
const left = '\u1EAF';
const right = 'a\u0306\u0301';

console.log(left.normalize('NFC') === right.normalize('NFC')); // true
console.log(right.normalize('NFC') === right);                // false
String.prototype.normalize() trả về một chuỗi ở dạng chuẩn hóa được yêu cầu; nó không sửa biến nguồn. Nếu chỉ chuẩn hóa lúc ghi mà quên chuẩn hóa khóa tra cứu, lỗi vẫn có thể tồn tại ở một đường xử lý khác.
Với một trường mà sản phẩm đã chọn NFC làm quy ước, có thể gom thao tác vào một hàm ở biên dữ liệu:
function toNfcText(value) {
  if (typeof value !== 'string') {
    throw new TypeError('Expected text');
  }
  return value.normalize('NFC');
}
Hàm chỉ xác nhận kiểu chuỗi và chuẩn hóa. Nó không trim, không chuyển hoa/thường, không bỏ dấu, không từ chối ký tự điều khiển và không phải schema validator đầy đủ.
3. NFC không đồng nghĩa bỏ dấu hay chống giả mạo
NFC giữ khác biệt có ý nghĩa giữa “a” và “á”. Nó cũng không tự làm A bằng a hoặc loại khoảng trắng. Nếu tính năng tìm kiếm cần không phân biệt dấu, hãy đặt tên và thiết kế riêng khóa tìm kiếm, đồng thời giữ tên hiển thị theo yêu cầu.
NFKC/NFKD còn xử lý tương đương tương thích, nên có thể gộp những dạng mà sản phẩm muốn phân biệt. Không chọn chỉ vì có vẻ “chuẩn hóa mạnh hơn”. Tương tự, các chữ nhìn giống từ những hệ chữ khác nhau không tự được coi là một bởi NFC.
Với chữ ký, hash hoặc giao thức yêu cầu byte chính xác, không chèn bước chuẩn hóa tùy tiện sau khi dữ liệu đã được ký. Cần tuân theo format và quy tắc canonicalization của chính giao thức.
4. Độ dài chuỗi khác số byte UTF-8
const encoder = new TextEncoder();
const a = '\u1EAF';
const b = 'a\u0306\u0301';

console.log(encoder.encode(a).length); // 3
console.log(encoder.encode(b).length); // 5
String.length đếm đơn vị mã UTF-16, không phải số ký tự người dùng cảm nhận. TextEncoder mã hóa văn bản thành UTF-8; độ dài mảng byte trả về là một phép đo khác.
Khi thiết kế giới hạn nhập liệu, viết rõ đang giới hạn byte, code unit hay cụm ký tự hiển thị. Frontend báo “tối đa 100 ký tự” nhưng backend áp giới hạn byte mà không giải thích có thể tạo trải nghiệm khó hiểu với tiếng Việt và emoji.
5. Áp dụng cho dữ liệu cũ cần kiểm tra collision
Giả sử hai record đang được lưu với hai biểu diễn ở ví dụ đầu. Sau khi tạo khóa NFC, chúng có thể rơi vào cùng khóa. Đó là một xung đột cần xử lý, không phải lý do tự động xóa một record.
- Chọn rõ những trường được phép chuẩn hóa và mục đích của chúng.
- Tính thử khóa mới trong môi trường kiểm thử hoặc quy trình audit chỉ đọc.
- Liệt kê nhóm trùng sau chuẩn hóa cùng ID và quan hệ liên quan.
- Thống nhất cách hợp nhất hoặc từ chối xung đột với chủ dữ liệu.
- Đồng bộ quy tắc giữa form, API, import và background job.
- Triển khai có kế hoạch khôi phục và kiểm tra lại uniqueness trên database thật.
NFC ở JavaScript không chứng minh collation của database đang so sánh giống hệt. Cần kiểm tra trên engine, kiểu cột và cấu hình thực tế. Chuỗi dùng để hiển thị và khóa dùng để định danh có thể cần được quản lý riêng.
6. Checklist kiểm thử văn bản đa ngôn ngữ
- Hai dạng dựng sẵn/tổ hợp được tìm thấy theo cùng quy tắc đã chọn.
- Chuẩn hóa lặp lại không làm dữ liệu tiếp tục thay đổi.
- Dấu tiếng Việt và khác biệt hoa/thường chỉ bị gộp nếu sản phẩm yêu cầu.
- Giới hạn độ dài dùng đúng đơn vị ở cả frontend và backend.
- Nhập liệu từ bàn phím, copy/paste và import đều đi qua biên xử lý nhất quán.
- Collision được phát hiện trước khi áp ràng buộc mới.
- Hash/chữ ký và dữ liệu cần bảo toàn nguyên byte được xử lý theo contract riêng.
Các ví dụ trong bài đã được chạy bằng Node.js local, gồm so sánh hai biểu diễn, NFC, kiểm tra kiểu và số byte UTF-8. Đây không phải kiểm thử migration hay collation trên database production.
Khi văn bản nhìn giống mà hành vi khác, hãy kiểm tra biểu diễn trước khi sửa giao diện hoặc thêm một lớp tìm kiếm gần đúng. Quy ước chuẩn hóa rõ ràng ở biên dữ liệu giúp hệ thống xử lý tiếng Việt nhất quán hơn.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.