
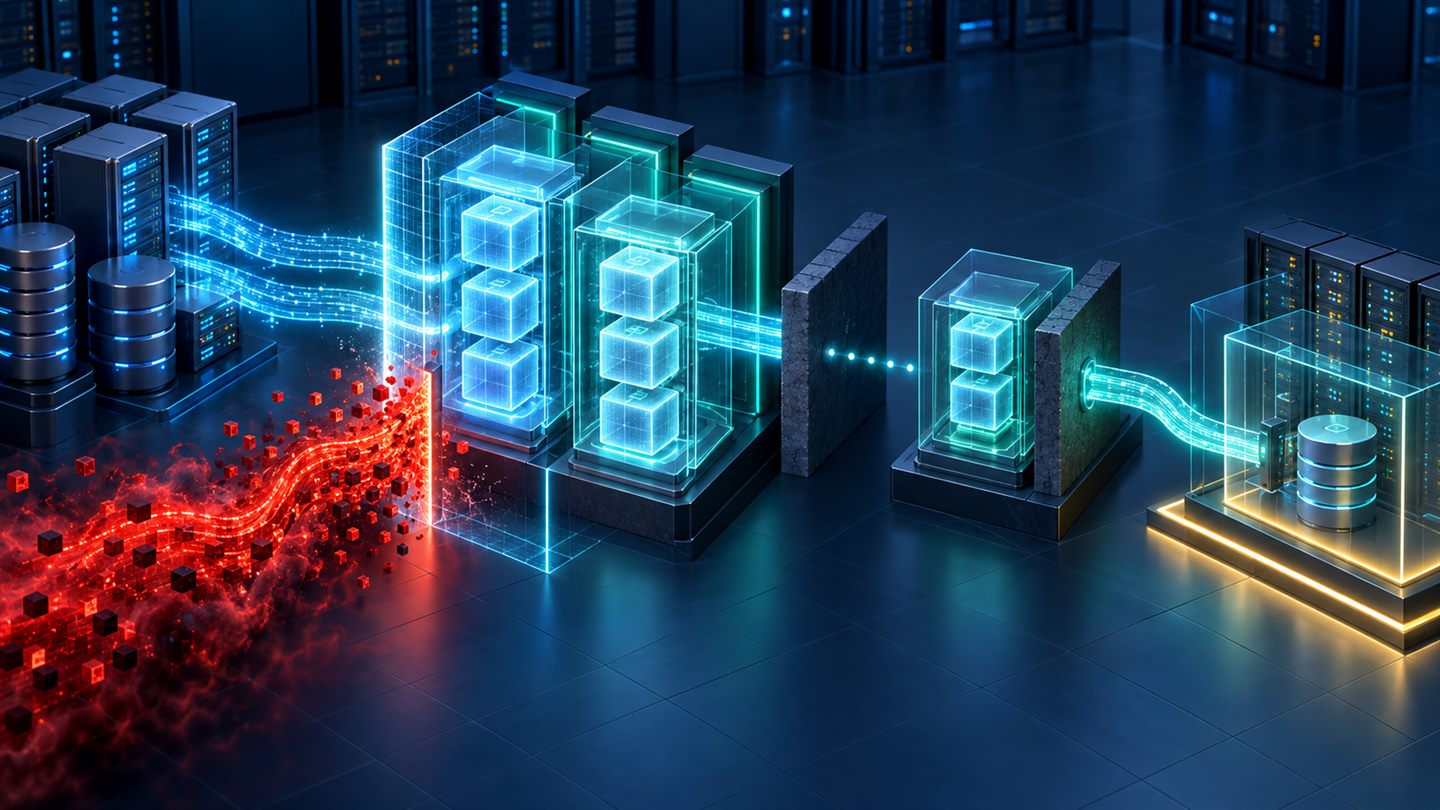
Backup chỉ có giá trị khi kẻ tấn công không thể sửa hoặc xóa nó trước lúc đội vận hành cần khôi phục. Một bản sao nằm chung tài khoản quản trị, luôn được mount vào mạng và cho phép xóa bằng cùng bộ thông tin đăng nhập với production có thể biến mất trong chính cuộc tấn công mà nó phải cứu doanh nghiệp.
Backup bất biến giải quyết một phần rủi ro đó bằng cơ chế WORM—ghi một lần, đọc nhiều lần—hoặc khóa retention, khiến phiên bản dữ liệu không thể bị ghi đè hay xóa trong khoảng thời gian đã định. Tuy nhiên, “không xóa được” không đồng nghĩa “dữ liệu sạch”, “khóa mã hóa an toàn” hay “khôi phục được đúng RTO”. Thiết kế tốt phải kết hợp tính bất biến, cách ly quyền quản trị và diễn tập phục hồi.
1. Bất biến khác snapshot thông thường ở đâu?
Snapshot tạo điểm khôi phục, nhưng nếu tài khoản có quyền quản trị vẫn có thể xóa snapshot thì ransomware hoặc kẻ nội bộ chiếm được tài khoản đó cũng có thể xóa. Cờ read-only ở hệ điều hành không đủ vì quản trị viên hoặc dịch vụ lưu trữ vẫn có thể thay đổi nó.
Với retention lock, mỗi phiên bản được bảo vệ đến một mốc thời gian. Trong chế độ nghiêm ngặt, ngay cả quản trị cấp cao cũng không thể rút ngắn retention. Một số nền tảng còn có legal hold, giữ đối tượng vô thời hạn cho đến khi một chủ thể được cấp quyền gỡ bỏ.
Tính bất biến bảo vệ phiên bản đã ghi khỏi sửa hoặc xóa; nó không phát hiện malware, không xác nhận dữ liệu đầy đủ và không thay thế kiểm soát truy cập.
2. Bắt đầu từ mô hình đe dọa
Đừng thiết kế chỉ cho tình huống máy chủ ứng dụng bị mã hóa. Hãy giả định kẻ tấn công có thể lấy tài khoản domain admin, token của phần mềm backup, quyền quản trị cloud, phiên SSO đang hoạt động hoặc quyền truy cập vào console của nhà cung cấp. Kẻ tấn công có thể:
- Mã hóa hoặc xóa dữ liệu production.
- Vô hiệu hóa lịch backup và chờ các điểm sạch hết hạn.
- Xóa catalog, cấu hình job hoặc lịch sử phiên bản.
- Rút ngắn retention nếu quyền cho phép.
- Xóa khóa mã hóa để biến bản sao còn nguyên thành dữ liệu không đọc được.
- Đưa dữ liệu đã nhiễm vào kho backup rồi chờ tổ chức phát hiện muộn.
Mô hình này dẫn tới yêu cầu quan trọng: kho phục hồi phải tồn tại ngoài “blast radius” của production và lớp điều khiển backup hằng ngày.
3. Đặt bất biến vào mô hình 3-2-1-1-0
Quy tắc 3-2-1—ba bản dữ liệu, hai loại phương tiện, một bản ngoài site—là điểm khởi đầu. Biến thể 3-2-1-1-0 bổ sung một bản offline hoặc immutable và không có lỗi sau kiểm chứng phục hồi. Các con số là cách ghi nhớ, không phải bằng chứng kiến trúc đã an toàn.
| Lớp | Mục tiêu | Kiểm soát chính |
|---|---|---|
| Production | Phục vụ nghiệp vụ | Least privilege, segmentation, EDR, logging |
| Backup vận hành | Khôi phục nhanh lỗi thông thường | Snapshot ngắn hạn, truy cập hạn chế |
| Kho immutable | Chống xóa và sửa có chủ ý | Object Lock/WORM, tài khoản tách biệt, retention |
| Bản offline hoặc air gap | Giảm phụ thuộc control plane trực tuyến | Ngắt kết nối vật lý hoặc logic có kiểm soát |
| Clean room | Khôi phục và kiểm tra an toàn | Mạng cô lập, quét malware, credential mới |
Không nhất thiết mọi hệ thống đều cần đủ năm lớp như nhau. Hãy phân loại theo tác động kinh doanh, RPO, RTO và nghĩa vụ lưu giữ để đầu tư đúng chỗ.
4. Tách miền quản trị, không chỉ tách bucket
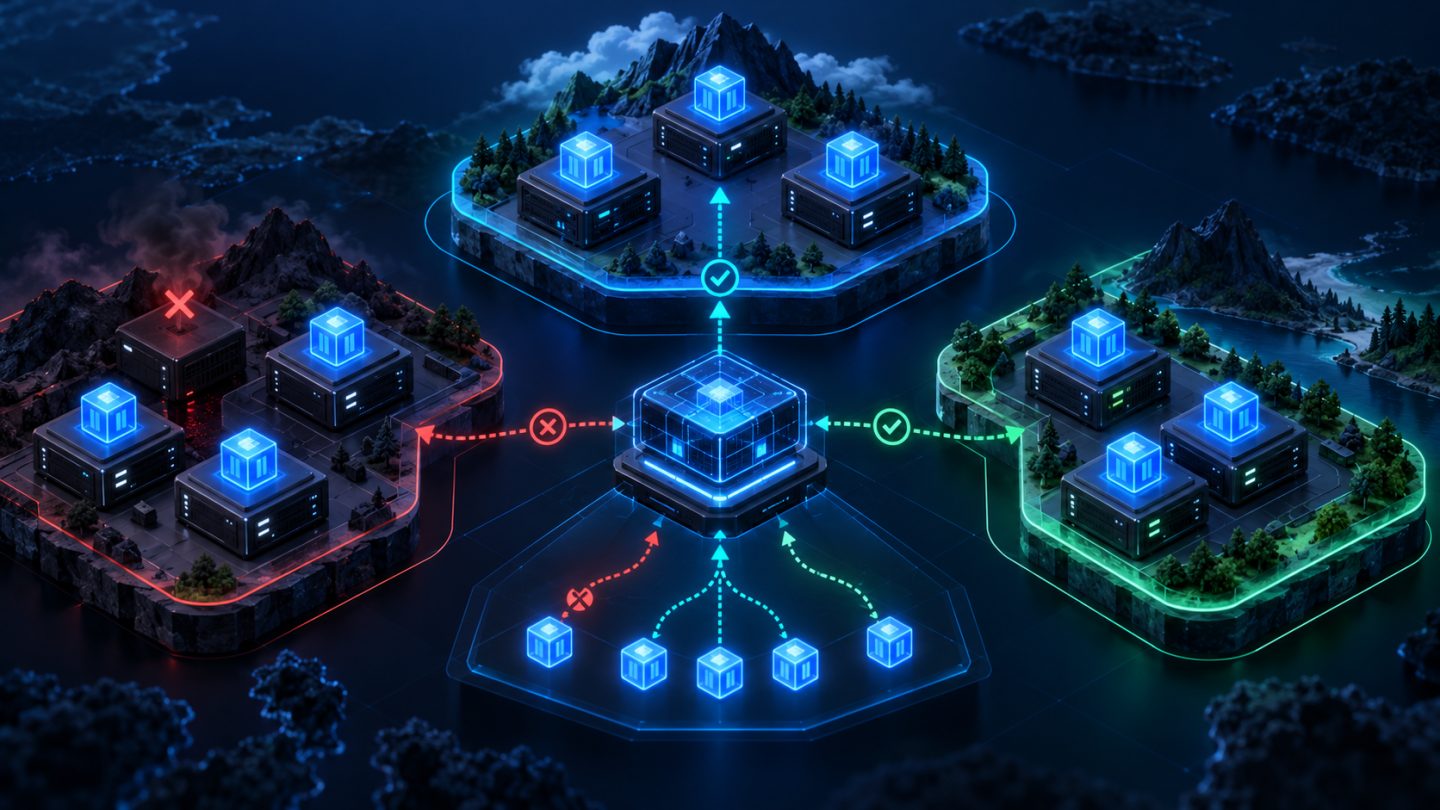
Một bucket khác trong cùng tài khoản chưa chắc là ranh giới an toàn nếu cùng administrator có thể xóa bucket, đổi policy, vô hiệu hóa khóa hoặc cấp quyền bypass. Kho immutable nên nằm trong account, subscription hoặc tenant chuyên dụng; vai trò sản xuất chỉ được ghi bản sao mới và không có quyền xóa, sửa retention hay quản trị khóa.
- Dùng tài khoản quản trị riêng, MFA chống phishing nếu nền tảng hỗ trợ.
- Không dùng chung tài khoản dịch vụ giữa production và kho phục hồi.
- Giới hạn vai trò ghi theo đường dẫn, nguồn và loại thao tác cần thiết.
- Giữ tài khoản break-glass ngoại tuyến, niêm phong quy trình sử dụng và ghi log mọi lần truy cập.
- Gửi audit log sang một nơi mà quản trị viên backup không thể tự xóa.
Nếu SSO doanh nghiệp là điểm truy cập duy nhất cho cả hai miền, việc chiếm SSO có thể phá hỏng sự tách biệt. Hãy thiết kế đường phục hồi danh tính độc lập nhưng được quản trị chặt chẽ.
5. Chọn chế độ khóa và retention
Các tên gọi khác nhau theo nhà cung cấp. Ví dụ, Amazon S3 Object Lock có Governance mode—người có quyền bypass đặc biệt vẫn có thể thay đổi—và Compliance mode, nơi phiên bản được bảo vệ không thể bị xóa hay ghi đè trong thời hạn, kể cả bởi root của tài khoản. Không nên suy rộng semantics này sang mọi sản phẩm; hãy thử trực tiếp hành vi xóa, rút ngắn retention và xóa account trước khi áp dụng.
Retention phải dài hơn thời gian kẻ tấn công có thể ẩn mình cộng thời gian điều tra và ra quyết định phục hồi. Nếu tổ chức thường mất 21 ngày mới phát hiện hành vi bất thường, khóa 7 ngày gần như không có ý nghĩa. Một chính sách minh họa có thể giữ daily 35 ngày, weekly 12 tuần và monthly 12 tháng; đây không phải công thức chung.
Chế độ khóa nghiêm ngặt có hệ quả tài chính: dữ liệu ghi nhầm vẫn phải được giữ hết hạn. Hãy chạy thử ở Governance, đo dung lượng và quy trình, sau đó mới áp dụng chế độ khó đảo ngược cho workload phù hợp.
6. Bảo vệ catalog, cấu hình và khóa mã hóa
Dữ liệu backup không phải thành phần duy nhất cần cứu. Không có catalog, đội vận hành có thể mất nhiều giờ tìm chuỗi incremental phù hợp. Không có cấu hình hạ tầng, DNS, chứng thư, secrets, license hoặc bản cài đặt, ứng dụng vẫn không thể hoạt động. Hãy sao lưu riêng các thành phần này, kiểm soát phiên bản và lưu bản tối thiểu ngoại tuyến.
Khóa mã hóa là một phụ thuộc đặc biệt. Nếu khóa bị xóa hoặc KMS chỉ tồn tại trong tài khoản đã bị khóa, bản sao immutable trở thành bất khả dụng. Thiết kế cần có chiến lược escrow/backup khóa theo khả năng nền tảng, phân quyền quản trị khóa khỏi quản trị backup và kiểm thử giải mã trong diễn tập.
7. Bản sao bất biến vẫn có thể chứa malware
Backup tự động trung thành sao chép cả dữ liệu tốt lẫn dữ liệu đã bị sửa. Vì vậy không nên restore thẳng vào production. Chọn điểm khôi phục dựa trên timeline sự cố, dựng clean room cô lập, quét IOC/malware, xác minh ứng dụng và chỉ mở kết nối sau khi thay credential.
Golden image và Infrastructure as Code giúp dựng lại nền tảng sạch nhanh hơn so với phục hồi nguyên máy đã bị xâm nhập. Tuy vậy, template và repository IaC cũng phải có bản sao ngoài miền quản trị bị ảnh hưởng.
8. Kiểm thử theo ba cấp
- Kiểm tra tự động hằng ngày: job hoàn tất, checksum hợp lệ, số lượng và dung lượng nằm trong ngưỡng, retention thực sự được áp dụng.
- Khôi phục mẫu định kỳ: chọn ngẫu nhiên file, database và máy ảo; giải mã, mở dữ liệu và so sánh tính nhất quán ứng dụng.
- Diễn tập toàn hệ thống: dựng danh tính, mạng, DNS, secrets, database và ứng dụng trong clean room; đo thời gian đến khi nghiệp vụ được xác nhận.
“Job màu xanh” chỉ chứng minh phần mềm backup báo thành công. RTO chỉ được chứng minh bằng thời gian phục hồi thực tế. Biên bản diễn tập cần ghi rõ điểm nghẽn, người phê duyệt, dependency thiếu và hành động khắc phục.
9. Giám sát dấu hiệu phá hoại backup
Tạo cảnh báo cho việc tắt job, thất bại liên tiếp, thay đổi retention, cấp quyền bypass, xóa hàng loạt, thay policy/KMS, đăng nhập break-glass và dung lượng backup giảm bất thường. Gửi cảnh báo sang kênh ngoài control plane đang được bảo vệ.
Cũng cần theo dõi “backup im lặng”: job vẫn thành công nhưng phạm vi dữ liệu đã bị thay đổi, database mới không được thêm hoặc agent chỉ gửi một phần. Đối chiếu inventory production với policy backup giúp phát hiện khoảng trống này.
10. Chi phí và vòng đời dữ liệu
Immutability làm tăng mức lưu trữ tối thiểu vì không thể dọn dữ liệu trước hạn. Dự báo chi phí theo tốc độ thay đổi, số phiên bản, retention và phí truy xuất. Lifecycle tiering có thể chuyển bản cũ sang lớp rẻ hơn, nhưng phải kiểm tra thời gian lấy dữ liệu và phí retrieval có phù hợp RTO hay không.
Đừng đặt retention dài cho mọi thứ. Tách dữ liệu nghiệp vụ quan trọng, log, cache và dữ liệu tái tạo được; mỗi lớp có RPO/RTO và retention riêng. Legal hold cũng không thay thế chính sách lưu giữ hồ sơ hay tư vấn tuân thủ.
11. Những lỗi thiết kế thường gặp
- Gọi snapshot là immutable dù administrator có thể xóa ngay.
- Dùng cùng credential, tenant và KMS cho production lẫn backup.
- Khóa dữ liệu nhưng quên catalog, cấu hình và khóa giải mã.
- Retention ngắn hơn thời gian phát hiện xâm nhập.
- Không cảnh báo khi quyền bypass hoặc policy bị thay đổi.
- Chỉ test restore một file, chưa từng dựng lại dịch vụ hoàn chỉnh.
- Phục hồi vào mạng đang nhiễm bằng credential cũ.
- Chọn Compliance mode trước khi hiểu tác động chi phí và tính không đảo ngược.
12. Lộ trình triển khai thực tế
- Lập inventory hệ thống, owner, dependency, RPO và RTO.
- Chọn một workload quan trọng nhưng phạm vi vừa phải để thí điểm.
- Tạo vault trong miền quản trị riêng; cấu hình vai trò chỉ ghi và retention thử nghiệm.
- Sao lưu catalog, cấu hình, IaC và phương án truy cập khóa.
- Bật logging bất biến và cảnh báo thay đổi kiểm soát.
- Thực hiện restore vào clean room, ghi thời gian và lỗi.
- Chỉnh retention/capacity rồi mở rộng theo từng nhóm dịch vụ.
- Diễn tập định kỳ và báo cáo RPO/RTO đạt được, không chỉ tỷ lệ job thành công.
Tài liệu tham khảo
- CISA: #StopRansomware Guide
- AWS: Locking objects with Object Lock
- NIST: Ransomware and Breach guidance
Kết luận
Backup bất biến là một ranh giới phục hồi, không phải nút bật duy nhất. Giá trị của nó đến từ bốn yếu tố đi cùng nhau: phiên bản bị khóa đủ lâu, quyền quản trị tách biệt, khóa và metadata vẫn dùng được, cùng quy trình restore đã được diễn tập trong môi trường sạch. Khi doanh nghiệp đo được RPO/RTO qua phục hồi thật, backup mới chuyển từ “có bản sao” thành năng lực chống chịu ransomware.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.