
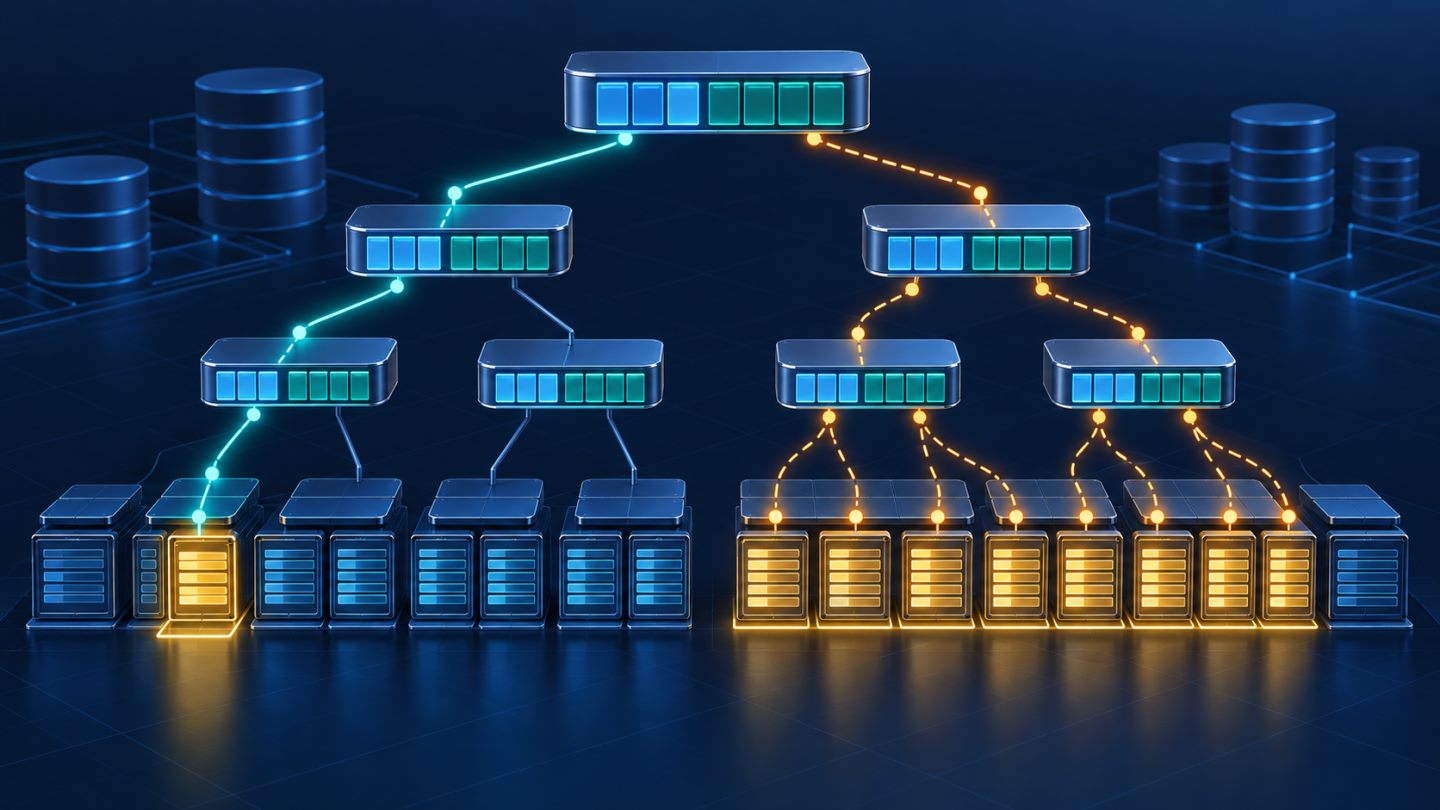
Composite index không phải một túi các cột; nó là một cấu trúc có thứ tự. Index (tenant_id, created_at) sắp khóa theo tenant trước, rồi mới theo thời gian bên trong từng tenant. Vì vậy nó rất phù hợp để lấy giao dịch mới nhất của một tenant, nhưng không tự động tối ưu truy vấn chỉ lọc theo created_at.
Hiểu thứ tự khóa giúp tránh hai cực đoan: thêm index cho mọi cột hoặc kỳ vọng một index nhiều cột giải quyết mọi truy vấn. Bài viết tập trung vào B-tree phổ biến trong PostgreSQL, MySQL và SQLite; chi tiết optimizer vẫn khác theo engine và phiên bản.
1. B-tree tổ chức dữ liệu ra sao?
B-tree giữ các key đã sắp xếp trong nhiều page cân bằng. Từ root, database chọn nhánh phù hợp cho tới leaf chứa key hoặc vùng key cần tìm. Leaf thường cho phép quét tuần tự một range, nên B-tree hữu ích cho equality, range và nhiều trường hợp sắp xếp.
Index tăng tốc bằng cách thu hẹp vùng phải đọc; nó không làm dữ liệu biến mất và cũng không bảo đảm optimizer luôn chọn index.
2. Composite key được so theo thứ tự
Với index:
CREATE INDEX idx_orders_tenant_created
ON orders (tenant_id, created_at);
Khóa được so như cặp: so tenant_id trước; chỉ khi bằng nhau mới so created_at. Có thể hình dung danh bạ sắp theo họ rồi tên. Tìm theo họ dễ; tìm mọi người có tên “An” mà không biết họ phải đi qua nhiều vùng.
| Truy vấn | Mức phù hợp điển hình |
|---|---|
tenant_id = ? | Dùng prefix dẫn đầu |
tenant_id = ? AND created_at >= ? | Equality rồi range, rất phù hợp |
created_at >= ? | Không có cột dẫn đầu; có thể phải quét rộng hoặc chọn plan khác |
3. “Leftmost prefix” là mô hình, không phải luật tuyệt đối
MySQL mô tả khả năng lookup theo các prefix trái. PostgreSQL nói index nhiều cột hiệu quả nhất khi có constraint trên cột dẫn đầu, nhưng optimizer hiện đại có thể dùng skip scan trong một số tình huống. SQLite cũng có chiến lược riêng.
Vì thế, đừng kết luận “thiếu cột đầu thì index hoàn toàn vô dụng”. Constraint ở cột sau có thể giúp filter trong index, covering hoặc skip scan. Câu hỏi thực tế là: plan đọc bao nhiêu entry/page và rẻ hơn phương án khác không?
4. Equality trước range
Mẫu thường hiệu quả là đặt các điều kiện equality ổn định trước, rồi cột range:
WHERE tenant_id = 42
  AND status = 'paid'
  AND created_at >= '2026-09-01'
CREATE INDEX idx_orders_lookup
ON orders (tenant_id, status, created_at);Hai equality xác định một vùng hẹp, sau đó database quét range thời gian. Nếu đặt created_at trước, một range rộng có thể khiến các cột phía sau không tiếp tục thu hẹp vùng scan theo cách mong muốn.
Đây là heuristic, không phải công thức mù quáng. Selectivity, distribution, loại truy vấn và optimizer đều quan trọng. Một cột boolean ít giá trị vẫn có thể đứng trước nếu mọi truy vấn đều khóa nó cùng tenant; nhưng cần đo.
5. Index có thể hỗ trợ WHERE và ORDER BY cùng lúc
SELECT id, total, created_at
FROM orders
WHERE tenant_id = 42
ORDER BY created_at DESC, id DESC
LIMIT 50;
Index (tenant_id, created_at DESC, id DESC) có thể tìm vùng tenant rồi đọc theo đúng thứ tự, tránh sort riêng và dừng sớm ở LIMIT. Tie-breaker id làm thứ tự ổn định.
Nếu direction, NULL ordering hoặc expression không khớp khả năng engine, optimizer vẫn có thể sort. Luôn xem plan thay vì suy luận chỉ từ tên index.
6. Range thường là điểm chuyển
Với (a,b,c), equality trên a và range trên b thường xác định phần index cần scan. Điều kiện c có thể được kiểm tra trong index, nhưng không nhất thiết giảm biên scan. Ví dụ:
WHERE a = 10 AND b BETWEEN 100 AND 200 AND c = 'x'Nếu c cần thu hẹp mạnh và workload quan trọng, có thể cân nhắc thứ tự khác—nhưng phải kiểm tra các truy vấn còn lại và ORDER BY. Không thiết kế index dựa trên một query cô lập.
7. Covering index giảm lookup bảng
Nếu index chứa mọi cột cần cho filter và output, engine có thể trả kết quả từ index mà không đọc row/table trong điều kiện phù hợp:
CREATE INDEX idx_orders_cover
ON orders (tenant_id, created_at, id, total);
Covering có thể giảm I/O, nhưng làm index lớn hơn, giảm fan-out, tăng cache pressure và chi phí ghi. PostgreSQL còn có INCLUDE để tách cột payload khỏi search key; khả năng và semantics khác giữa engine.
8. Selectivity không phải tiêu chí duy nhất
Lời khuyên “đặt cột selectivity cao nhất trước” quá đơn giản. Thứ tự phải phục vụ mẫu truy vấn: equality, range, join, ORDER BY và LIMIT. Cột tenant có thể không cực kỳ selective toàn bảng nhưng là boundary bắt buộc của mọi request; đặt nó đầu giúp vừa đúng phạm vi vừa sắp xếp tiếp theo.
9. OR, expression và ép kiểu
Predicate dùng hàm hoặc cast có thể không khớp index thường:
WHERE LOWER(email) = 'a@example.com'
WHERE DATE(created_at) = '2026-09-28'
Cân nhắc expression index/generated column hoặc viết range sargable. OR có thể khiến optimizer union nhiều index hoặc chọn scan. Kiểu dữ liệu, collation và implicit cast cũng có thể ảnh hưởng khả năng dùng index.
10. Chi phí của mỗi index
- Tốn disk và buffer cache.
- Mọi insert/delete và nhiều update phải duy trì index.
- Page split và write amplification tăng.
- Planner có thêm lựa chọn cần ước lượng.
- Index gần trùng nhau gây lãng phí và làm migration lâu hơn.
Không giữ index chỉ vì nó “có thể hữu ích”. Đo usage, xác nhận workload và kiểm tra index nào là prefix dư thừa—nhưng chú ý uniqueness, ordering, INCLUDE và đặc thù engine trước khi xóa.
11. EXPLAIN là bước bắt buộc
EXPLAIN ANALYZE
SELECT id, total
FROM orders
WHERE tenant_id = 42
  AND created_at >= '2026-09-01'
ORDER BY created_at DESC
LIMIT 50;
Xem loại scan, index condition, filter, rows estimated/actual, sort và I/O. Sai lệch lớn giữa estimated và actual có thể chỉ ra statistics cũ hoặc dữ liệu lệch. Không chạy EXPLAIN ANALYZE vô tư với câu lệnh ghi vì nó thực thi câu lệnh.
12. Quy trình thiết kế
- Thu thập truy vấn thật và tần suất/latency.
- Ghi rõ equality, range, join, order và output.
- Đề xuất thứ tự từ prefix dùng chung, equality, rồi range/order.
- Kiểm tra khả năng covering nhưng giữ index gọn.
- Chạy EXPLAIN trên dữ liệu có distribution gần production.
- Benchmark cả read và write.
- Theo dõi sau deploy và loại index dư thừa có kiểm soát.
Tài liệu tham khảo
Kết luận
Thứ tự cột composite index quyết định cách key được sắp và vùng nào có thể được định vị nhanh. Bắt đầu từ mẫu truy vấn, ưu tiên prefix equality hữu ích trước range, cân nhắc ORDER BY và covering, rồi xác nhận bằng EXPLAIN cùng benchmark. Index tốt không phải index chứa nhiều cột nhất, mà là cấu trúc nhỏ nhất phục vụ workload quan trọng với chi phí ghi chấp nhận được.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.